thedeemon: (Default)
Я недавно писал про новый ЯП Гусь, который в моем персональном бенчмарке оказался вдвое медленнее Раста. Так вот я тут взял вариант решения со своей имплементацией хэш-таблицы (SoA вместо AoS), взял решение на Свифте и натравил на них GPT 6 Astra, чтобы она их сравнила и исследовала что там тормозит. Оказалось, больше всего времени тратилось на итерирование хэш-таблицы, и небольшая очевидная оптимизация одной единственной функции (dict.each) все меняет. У меня там в хэш-таблице есть массив битов, говорящих свободна ячейка таблицы или занята. Функция итерации была максимально наивная: проверяем очередной бит, если это используемая ячейка, передаем ее содержимое. Так вот, если эту битовую карту читать сразу по 64 бита и использовать функцию ctz() (count trailing zeros), которая одной инструкцией процессора делается, то сразу хождение вдоль хэш-таблицы делается намного быстрее. Почему-то компилятор сам так не догадался оптимизировать, нужно это в коде прописывать. Астра все написала с первого раза. В итоге с новой реализацией хэш-таблиц Гусь оказался чуточку быстрее Раста, на доли секунды буквально. И памяти еще меньше теперь ест. Новые цифры и исходники все там же.
thedeemon: (Default)
Несколько недель назад мир был потрясен выходом нового языка программирования, который заявил, что в среднем быстрее идиоматичных С++ и Раста, весь из себя type safe и memory safe, с автоматическим управлением памятью, но без сборщика мусора, без подсчета ссылок и без возни с указанием лайфтаймов.
Язык называется Goose и задизайнен человеком, который до этого уже выпустил языки Sheep, SHEEP, Goat, PIG, COW, MOLE, Frog, Horse, Toad, Bear, Boar, и конечно Lobster. А еще он же создал языки Apfelstrudel, Kartoffel, Sauerkraut, Schnitzel, Sauerkraut II и Aardappel. А также множество других, включая E на Amiga. Неполный список тут.

Основная идея в Гусе про управление памятью довольно занятная. Все значения в памяти по сути своей бывают двух видов: постоянного размера (всякие bool, u8, u32, i64, f64, структуры из них, массивы постоянной длины, кое-что еще...), и динамического размера (resizable), вроде массивов, которым надо уметь расти, ну и всего того, что из них можно смастерить. Он при запуске программы создает N стеков - арен, и все аллоцирует в них. Компилятор сам решает что куда положить, в частности, результат вызова функции аллоцируется так высоко по стекам, насколько он потом понадобится. В каждом стеке в каждый момент времени может быть сколько-то данных статичного размера и ровно один resizable объект - в конце, соответственно он может свободно расти и скукоживаться, места в таком стеке дофига. И язык вводит определенные ограничения: resizable значение может быть в глобальной или локальной переменной (в том числе в by-value параметре функции, он как локальная переменная), и может быть последним полем в структуре, тогда вся структура считается resizable объектом, и на ней теперь те же ограничения. Недавно добавили еще root structs, где много полей могут быть resizable объектами, и такая структура тоже может лишь жить в переменных. Главное наблюдение: когда мы смотрим на исходник программы, количество переменных в ней конечно. Т.е. всего resizable объектов в программе может быть конечное количество. И не все они живы одновременно, компилятор это отслеживает, и старается стеки переиспользовать, создавая лишь столько стеков/арен, сколько ему кажется может максимум быть одновременно живых переменных, ссылающихся на resizable объекты. Это количество N определяется статически. И при запуске программа через mmap раделяет виртуальное адресное пространство на N частей до 256 ТБ каждая, а физическая память под них выделяется страницами уже по мере реального использования. При этом адрес каждого стека фиксирован, и адрес каждого динамического массива фиксирован, и когда он растет, он никуда не двигается, поэтому ссылки на старые элементы массива не протухают при его росте, в отличие от языков с обычными аллокаторами, где при ресайзе часто копируют все данные массива на новое место.
Получается, что в Гусе нельзя класть в массивы resizable объекты, но можно класть их слайсы, т.к. слайс это пара из указателя и длины, само по себе это значение фиксированного размера. Насколько сложно с такими ограничениями жить? Пока не очень понятно, но похоже, что вполне себе можно.

Там есть еще несколько интересных решений, вроде массивов разноразмерных элементов, в том числе алгебраических типов (в отличие от Раста разные варианты одного алгебраика тут разное количество байт занимают), к таким массивам нельзя обращаться по проивольному индексу, но можно по ним итерироваться, т.е. это по сути работа с сериализованными потоками данных на уровне языка. Еще есть механизм относительных ссылок, где индекс на уровне типа привязан к конкретному массиву и может быть представлен маленьким значением вроде u16, так можно экономить память на указателях. Еще в Гусе нет исключений, но есть забавный return from, когда можно вернуться из функции сразу на несколько фреймов выше (проверяется статически).

Компилируется все через генерацию Си и вызов вашего сишного компилятора. Бинарники получаются довольно маленькие - десятки килобайт для небольших программ.

Поскольку у меня давно был свой бенчмарк разных языков на одной задаче про byte pair encoding, я конечно сделал перевод и на гуся, надеясь восхититься его быстротой. Результат получился в 2 раза медленнее Раста и в 2.5 раза медленнее Свифта. Зато памяти съел меньше всех. Я подумал, что дело может быть в реализации хэш-таблиц, попробовал другую их реализацию, ближе к свифтовой, но быстрее не стало. Сгенерированный гусем Си код доволько страшненький, и возможно он не очень хорошо оптимизируется сишным компилятором, не так хорошо как генерация LLVM Растом и Свифтом напрямую...

Еще меня приятно порадовал AI: в редакторе Zed они для автодополнения кода какую-то недорогую быструю модель используют, на которую даже токены не считают, и вот она легко подхватила код на этом новом языке и осмысленные вещи стала подсказывать. Ну и GPT 6 неплохо тоже справился с модификацией кода хэш-таблицы на Гусе.
thedeemon: (Default)
How does a computer work?
As some of you likely know, inside your computer are millions (or even billions) of little men.

Those men are constantly dashing around to find and execute simple instructions. An instruction might, for example, tell a little man to add or subtract two numbers or send a message to another little man.

Такими словами начался ICFP Contest 2026 в прошедшие выходные. Я как раз последние дни слушал книжку 1Q84, где фигурируют мистические существа, которые там называются Little People. Хорошо совпало.

Тут в соревновании нужно было писать программы в виде 2D карт: программа состоит из набора прямоугольных комнат, в каждой комнате ходит по клеточкам человечек, выполняя инструкции, записанные в этих клеточках. У человечка есть два регистра А и В для арифметических операций, вроде A = A + B, A = A * B и т.п., и еще один регистр для циклов, куда можно записать число, можно уменьшать на единицу, и можно поворачивать или нет в завивимости от того, ноль там уже или еще нет. Также есть команда поворота, где направление определяется знаком регистра А. Комнаты могут соединяться трубами, по которым человечки могут посылать друг другу числа (из регистра А). Числа по трубе идут небыстро - по клеточке за такт. Есть две особых комнаты I и O - Input и Output.
Еще там бывают экраны, где можно рисовать по пикселям картинки, но их я не касался.

Вот так, например, выглядит программа, получающая на вход число n и вычисляющая 1 + 2 + 3 + ...n.


Человечек начинает в клетке @ и двигается вправо пока команда v не повернет его вниз, а < влево.
По пути он тут выполняет следующие команды:
r: A = input number
M: B = A
*: A = A*B
+: A = A+B
M: B = A
2: A = 2
W: swap A and B
/: A = A / B
s: send A to output

Так вычисляется (n*n+n)/2, искомый ответ.
Количество очков зависит от размера программы (максимум из длины и ширины) и количества операций.
Что забавно, эта первая программа была такая простая, что все ее быстренько как-то решили и побежали дальше, не пытаясь оптимизировать. У меня она сперва помещалась в квадрат 9х9, но потом я к ней вернулся и уместил в 8х8. Такая оптимизация привела к тому, что мое решение оказалось лучше всех:


rank 1 of 267 означает, что на тот момент из решений 267 команд это мое на 1-м месте.

В других задачках мои решения были довольно посредственные, но я там и не пытался сильно оптимизировать, мне было интересно просто получить что-то работающее. Например, в другой задачке программа должна была сортировать списки чисел. Причем не один, а именно несколько разных списков по очереди. На входе список из N чисел кодировался последовательностью из N+1 чисел, где самое первое было N - длина. Тут вопрос был в том, как вообще оперировать набором чисел неизвестной заранее длины, если у человечка всего две руки, два регистра, и большинство операций задействуют их оба. Решением оказалось запихать их всех в трубу и гонять по кругу, так труба становится памятью для последовательности чисел. По правилам труба из комнаты нe может приходить в нее же, пришлось сделать вторую комнату, откуда приходящие числа по второй трубе возвращаются в исходную комнату.


В основной же комнате человечек смотрит на приходящие числа, сравнивая каждое с предыдущим и отправляя дальше меньшее из двух, так за один круг последовательность проходит через одну итерацию сортировки пузырьком. Если ни разу за проход порядок чисел не был изменен, то последовательность уже отсортирована и осталось ее отправить на выход. Но вот беда, у нас нет третьего регистра, чтобы помнить делали мы перестановку или нет. Вместо этого состояние кодируется местоположением человечка: его цикл инструкций был продублирован рядом, и исходно он бегает по первому циклу, и если делает перестановку чисел, то переходит во второй такой же цикл. Когда первый или второй цикл кончается (закончилась одна итерация обработки списка), то если это закончился первый цикл, значит ни одной перестановки чисел не было в этой итерации и можно переходить к выводу. Если же человечек закончил второй цикл, значит перестановки были, и нужно продолжать итерации, возвращаемся к первому циклу.

В еще одной задачке нужно было проверять последовательности вроде [(){}]{[(){[(]}[]]} на сбалансированность скобок. Скобок три вида, и тут нужен стек. Но сказано, что максимальная глубина вложенности во входных последовательностях - 32. А числа в регистрах 64-битные. Т.е. в регистр как раз можно уместить 32 значения от 0 до 3! Но вот беда, чтобы сравнить входной символ с константой (ASCII кодом какой-то скобки) уже нужны оба регистра. Где же хранить стек? Пришлось привлечь еще человечков.


Первый получает на вход ASCII коды - исходные данные, и посылает в следующую комнату команды из двух чисел, где первое 0 или 1 говорит кладем мы на стек или снимаем, а второе - 1-3 - тип скобки. По условию, программа должна вернуть 0 если баланс скобок сходится, или позицию (начиная с 1) символа, где скобка неправильная, или N+1 если дошли до конца и не все скобки были закрыты. Т.к. у человечка, хранящего стек, уже не было свободных рук, за позиции и вывод результата отвечал третий человечек. Занимающийся стеком человечек посылал ему 1 каждый раз, когда успешно клал значение на стек или когда снятое со стека значение совпадало с требуемым, но если что-то шло не так или в конце последовательности стек был не пустой, посылал 0 - ошибку. Третий человечек суммировал приходящие единички, чтобы отслеживать позицию, и когда видел сигналы об ошибке или конце данных, посылал на выход накопленную позицию или 0 если все ок.

Чтобы в регистр записать число от 0 до 9, достаточно просто поставить такую цифру на пути человечка. Для чисел больше 9 нужно десятичную запись числа взять в кавычки.

Еще в одной задачке на входе ничего не было, а на выход нужно было выдать конкретный текст из почти трех тысяч символов. Вручную такое писать уже не будешь, тут я подключил ИИ, чтобы тот сделал генератор последовательностей команд. Уложил их змейкой, и столкнулся с проблемой, что между кавычками не должно быть ничего кроме цифр и пустых клеток, но не только на пути человечка, а везде - как по горизонтали, так и по вертикали. В программе выше я поэтому выравнивал кавычки по вертикали. Но в программе из 9к операций так делать уже сложно (или очень неэффективно). Потому сгенерил последовательность команд, где такие константы в кавычках не используются вовсе. Такая программа помещалась в квадрат 102х102. Но так просто неинтересно, поэтому я добавил еще простенького сжатия: нашел самые повторяющиеся в тексте последовательности символов (вроде " and "), и три из них закодировал отдельно, заменив одним байтом. Такой слегка сжатый текст уже требовал чуть меньше операций, он отправлялся по трубе во вторую комнату поменьше, где те три особых байта триггерили вывод трех особых последовательностей, а остальные байты передавались на выход как есть. Получилось уместить все в 99х99.


А, еще была задачка про разворачивание списков длиной до 16, ее я решил тупо - 16 труб разной длины, первый элемент идет по самой длинной трубе и приходит последним, последний наоборот по самой короткой и приходит первым, и т.д.

Ну и вот, а за остальные задачки я не брался.
thedeemon: (Default)
Пару лет назад я писал о том, как одну свою программку перевел клодом на несколько языков и получился небольшой бенчмарк (в основном про хэш таблицы, маленькие структуры и optionals).

На днях один добрый человек глянул там на код на джаве и резонно заявил, что так никто не пишет, а надо хотя бы библиотеку fastutil для таблиц взять, чтобы не было так много боксинга, как в наивном переводе. Хотя изначально я ограничивал сравнение только вариантами, где используется лишь стандартная библиотека, тут решил провести эксперимент, благо сейчас с ИИ это дело минутное. В общем, сделал вариант с fastutil и заодно в других местах поубирал аллокации, в горячих циклах остались примитивные инты. Получилось почти вдвое быстрее чем было, но все еще вдвое медленнеe чем был C# без таких оптимизаций.
И раз уж вернулся к тому бенчмарку, пересобрал без изменений старые программы на некоторых других языках более свежими версиями компиляторов. И тут самое интересное: некоторые за 2 года очень неплохо так ускорились!

Swift  v5.10       57s  -->  v6.3         41s
Rust   v1.79.0     59s  -->  v1.96.1      52s
C#     dotnet8.0   73s  -->  dotnet10.0   62s
D      LDC2 1.39  132s  -->  LDC2 1.42   106s

Тут 3 из 4 используют LLVM, и похоже в ней за последние 2 года большой прогресс был. Но наверняка и другие важные изменения произошли, особенно в Свифте. Приятно видеть такое улучшение!

Кстати про спецолимпиады, ICFPC стартует в эту пятницу.

Witchfire

Jul. 16th, 2026 04:28 pm
thedeemon: (Default)
Есть такой сервис облачного гейминга GeForce Now от nvidia, у них можно играть через браузер, а есть нативный клиент, где качество картинки заметно выше. Раньше нативный клиент был лишь под винду и мак, мне приходилось доставать и подключать ноут с виндой чтобы им пользоваться. А в начале этого года я обнаружил, что теперь у них есть нативный клиент под линукс и он отлично работает, и я теперь могу играть с основного компа. Счастье пришло!

Думал, буду играть в 붉은사막 Crimson Desert, которую давно ждал. В марте она наконец вышла, я чуть ли не в первый день приобрел, но так толком и не начал. Потому что слишком увлекся другой игрой, о которой хочу тут поведать.

Называется она Witchfire, делает ее небольшая польская команда, делает давно, но пока она доступна в режиме early access, официальный релиз 1.0 еще не состоялся, хотя уже близок.

По жанру это какая-то смесь extraction shooter и RPG в очень готическом мире с огнестрельным оружием и магией. В первую очередь это шутер в очень красивом сеттинге.


Но если в традиционных шутерах ты несешься через последовательность уровней, нигде долго не задерживаясь и не возвращаясь, то тут ( Read more... )
thedeemon: (Default)
Последнее время все больше слухов о том, что Apple вот-вот выпустит раскладной телефон iPhone Ultra наподобие Samsung Fold и Pixel Fold. Когда самсунг стал такие выпускать, я подумал, что они не наберут популярность и останутся сомнительной нишевой диковинкой, пока Apple не сделает свой, тогда-то уже все побегут на них и скажут, что это хорошо. Посмотрим, сбудется ли. А пока могу поделиться опытом.

У меня Samsung Fold - основной телефон уже пятый год. Пару лет проходил с Fold 3, теперь третий год живу с Fold 5. И могу сказать, что по крайней мере для меня это самый лучший девайс вообще. Первый месяц было странно и непривычно. Потом привыкаешь и всё, обратно на узкие уже вообще не хочется. Формула его проста: в кармане он телефон (всегда с собой), а в руках он планшет. Т.е. всегда с собой девайс с достаточно большим экраном, но нет вопросов о том, как его таскать, ибо таскается как обычный телефон. Экран почти квадратный, видео на нем смотреть не особо удобно (но мне и не надо, для видео есть другие девайсы), зато можно читать статьи, всякие простыни текста на картинках и без, можно немножко программировать и работать в шелле/ssh, ну и еще хорлшо, разделив экран на две части, следить за доставщиком еды или такси, одновременно почитывая твиттер.


( Read more... )

Не имеющие фолдов люди первым делом заводят разговор про ложбинку-складку посередине экрана, но на практике ее обычно вообще не замечаешь, как на фотках тут.

А, еще такой телефон хорош для селфи: когда его раскладываешь, то с одной стороны у него большой экран, а с обратной - экран поменьше и основные камеры. Соответственно, можно перейти в режим, где тот экран поменьше показывает что видит главная камера, и можно ею делать селфи. Когда большой экран на тебя смотрит, под ним тоже есть еще одна камера, но у нее качество похуже.
Кстати про камеры. Когда у меня был Fold 3, он фоткал не так хорошо как Pixel, и я тогда думал, вот выпустил бы гугл пиксель в таком формате, был бы телефон мечты. Потом гугл таки выпустил свой фолд, но довольно странной формы и начинки, и желания его приобрести у меня не возникло. Потом я перешел на Fold 5 от самсунга, а там камера уже достаточно хороша, можно ничего больше уже не хотеть.

Насколько такой девайс надежен? Первое, что с ним случается, это защитная пленка на внутреннем экране через какое-то время начинает идти пузырями. Но ее можно снять совсем, и все работает дальше ничуть не хуже. А потом уже как повезет. В Fold 3 у меня через 2 года перестал работать вайфай. Видимо, от складывания-раскладывания контакт с антенной повредился. В Fold 5 антенны все работают, но поломался USB порт. Что вообще не редкость, многие мои предыдущие телефоны тем же страдали. Т.е. в целом мой опыт говорит, что супер надежности в таком девайсе ожидать не стоит. Не знаю как у гугла и других производителей, и тем более никто не знает как хорошо будут работать эплловские. Зато сам формат прекрасен, не стоит его бояться, а рекомендую присмотреться, таков мой совет.

Civilizing

Jun. 26th, 2026 03:43 pm
thedeemon: (Default)
В преддверии выхода Одиссеи Нолана вспомнил, что давно хотел послушать курс лекций Civilizing the Barbarians, посвященный основополагающим текстам и авторам западной цивилизации. Начиная с Гомера как раз. И послушал. Не могу сказать, что так уж много узнал конкретно про Одиссею, но в целом лекции очень приятные. Читал их, неожиданно, Александр Степанов - автор STL (стандартной библиотеки шаблонов) в C++. Тут он поражает эрудицией по части истории и литературы. Видно, что может часами говорить про Махабхарату, про древних евреев, про историков и философов древней Греции и Рима, про Талмуд, Библию, про массу других текстов, авторов, переводов, стран и культур. Вопреки современным мемам о том, что все мужчины регулярно думают о римской империи, все эти темы мне не были близки, но тут заслушался. При этом там просачиваются и обрывочные сведения о самом Степанове. Как он мигрировал в Штаты в 70-х, и упоминает, что СССР лишил его гражданства. Что сам он католик. Как прочитанная в отрочестве книга Светония сделала его диссидентом... :) Там в плейлисте 34 видео: 17 лекций и 17 сессий с вопросами и ответами. К сожалению, там не весь курс, а лишь первая половина или даже меньше. Он собирался дойти до Шекспира, но тут все обрывается на ранних христианах и византийской империи. Я не понял, то ли лекции прервались, то ли просто не все были записаны / выложены.
thedeemon: (Default)
Когда-то на заре тысячелетия мы с моей будущей женой были в Тунисе. Там по пляжу ходил местный зазывала и кричал на ломанном русском "Три часа тридцать семь минут! Пиратский корабль кататься! Три часа тридцать семь минут! Пиратский корабль кататься!". Мы так и не покатались, но его фраза врезалась в память.

В молодости много раз встречал упоминания книги "Атлант расправил плечи". По упоминаниям и отсылкам тогда сложилось впечатление, что это библия либертарианцев и очень важный текст в определенных кругах, видимо переоцененный. Читать ее тогда даже не пытался, отложив на возможное далекое будущее, ознакомиться как-нибудь. Потом в какой-то момент я видел, что вышел фильм. Не стал тогда смотреть, подумав, что сперва стоит почитать оригинал. Еще позже она мне попалась в виде аудиокниги на Audible, и оказалось, что там длина больше чем у Войны и Мира - более 60 часов, куда это годится? Но т.к. я последнее время постепенно исправляю свои cultural gaps, в этом году все же собрался послушать и посмотреть.

Вы любите мюзиклы? Когда идет фильм нормально, но вдруг прерывается на песню и танцы, а потом идет дальше, и так много раз. Ужасно! :) Вот эта книга это тоже своего рода мюзикл. Там то идет себе книга с каким-то сюжетом, где что-то происходит, а потом вдруг кто-то из героев разражается длинным ненатуральным монологом, подобно песне в мюзикле. И практически все эти монологи, хоть и произносятся разными героями, звучат почти одинаково и повторяют одну и ту же простую мысль, которую наверняка можно выразить на полстраницы, а может быть даже в одно предложение, как например в цитате Thomas Sowell: “What exactly is your ‘fair share’ of what ‘someone else’ has worked for?” И когда кажется, что к такому ритму мюзикла привыкаешь, тут наступает момент, где герои хакают радиостанцию и один из них выступает со своей речью к массам. Я посмотрел, сколько в моей аудиокниге его монолог занял по времени. Три часа тридцать семь минут.

Если до этого еще как-то можно было стараться принимать текст за книгу, пусть о вымышленных событиях в вымышленной стране, то тут уже больше не получается. Надо быть совсем аутистом, чтобы допустить, что люди стали бы это все слушать по радио, с учетом длины и содержания передачи. Тем не менее, ознакомиться с текстом всем полезно, это такой гимн антикоммунизма, показывающий супер подробно на множестве примеров к чему коммунистические идеи ведут. Сейчас в Англии у власти лейбористы, и частенько когда они свои идеи и инициативы озвучивают, так и хочется их в эту книжку носом ткнуть.

Что до фильма. Кажется, что это было недавно, но оказывается 15 лет прошло с выхода. Выхода первой серии, оказывается там 3 серии было, между 2011 и 2014 годами. Я еще подумал, как такую книгу вообще можно экранизировать. Ну вот так можно - плохо. С одной стороны, фильм довольно четко следует тексту. Но, конечно, с учетом объема и характера текста, пришлось 90% пропустить. И для тех, кто книгу не читал, получилось какое-то скучное недоразумение с ужасным кастингом и смешными спецэффектами. Во всех трех сериях совершенно разные актеры, в каждой серии тех же героев играют совсем другие люди. Бюджет был совсем небольшим, но сборы у всех трех были намного меньше, т.е. это был полный флоп. Собственно, из-за финансовых проблем и не получалось тот же набор актеров сохранить, приходилось новых брать. Thank you for your attention to this matter.
thedeemon: (Default)
У меня теперь английская жена. И дети. Да и сам я. :)


Интересный момент: британское гражданство это такая MLM-схема, ну или частный клуб, как посмотреть. Чтобы доказать, что он достойный приличный человек ("of good character"), каждый кандидат должен предоставить двух человек, которые тут его знают не меньше трех лет, имеют приличные профессии и должности (из официального списка на gov.uk), и хотя бы один из них должен быть гражданином. И каждый референт должен предоставить свои персональные данные, включая адреса проживания за последние 3 года, и подписать бумагу, где подтверждает свое знакомство. Причем если подаешь всей семьей, то эти референты должны быть все разные, нам на четверых нужно было восемь человек найти - детям нужно тоже. Благо, учителя годятся для такой роли и охотно соглашаются помочь. Мне как асоциальному интроверту эта часть казалась самой пугающей, но в итоге ничего, набрали даже с запасом. И из 8 человек лишь один оказался не гражданином - мой начальник, француз, живущий тут с 90-х годов.

А так весь путь включал в себя экзамен по английскому для меня (еще до первого приезда, когда рабочую визу получал), экзамен по английскому для жены (когда рабочая виза истекла и мы делали ВНЖ), очень забавный тест "Life in the UK" для нас обоих (тоже перед получением ВНЖ), ну и кучу всяких анкет, сканов документов, денег и терпеливого ожидания. К счастью, никаких проблем и отказов ни на одном этапе не было.

При подаче на гражданство нужно указать даты всех поездок за пределы UK за последние пять лет (там есть определенные лимиты на то, как много можно отсутствовать, иначе не дадут). Но оказалось, спасибо ковидным локдаунам, быстро текущему времени и общей занятости, что мы всего-то дважды выезжали, из пяти лет только три недели провели не тут.
thedeemon: (Default)
Наслушавшись похвал в адрес оконного менеджера Niri, пару недель назад решился его поставить, консультируясь у ИИ по всем возникающим вопросам. Эта штука управляет окнами, по умолчанию растягивая их по вертикали на весь экран, а по горизонтали - на сколько-то (у меня по умолчанию 50%, с возможнстью переключиться на 100% или 1/3 или 2/3), и при создании новых окон старые не меняют размера, а все выстраиваются в горизонтальный ряд, который обычно шире экрана, и по нему можно скроллить. И таких горизонтальных рядов можно иметь сколько угодно, перемещаясь так в 2D по виртуальному пространству из окон. Управление с клавиатуры очень простое, быстро привыкаешь.

Первое впечатление сразу после установки самое яркое, конечно: серый экран и только памятка про горячие клавиши, которыми можно управлять окошками (но ни одного окна еще не создано), и пара кнопок чтобы запустить шелл alacritty (который у меня не был установлен) и какой-то лончер, которого у меня тоже не было. В итоге ничего запустить вообще было нельзя, только выйти вон можно. Но ничего, поставил какой-то лончер wofi (список программ с поиском для запуска оных), настроил запуск нужного шелла (Warp сначала не хотел работать, но заработал после установки xwayland-satellite), и для всяких удобств и красот я поставил шелл Noctalia, рисующий наверху бар со всякой информацией и менюшками управления тем и сем, и он же за обои отвечает. Получилось весьма приятно:


Еще поначалу оказалось, что не могу на русский переключиться. Оказалось, включается изменением одной строки в файле настроек Niri. Причем закомментированный образец там как раз про русскую раскладку. Потому что автор Niri - некий Иван Молодецких, похоже с моего факультета в МГУ, и участвующий в той же лаборатории машграфики, где я сам был 20 лет назад.

В редакторе Zed, как и в терминале, настроил немножко прозрачности, мне нравится как зелень с фона слегка проступает, так оно приятнее чем на однородную стену пялиться. Так и живу теперь, очень доволен.


Кстати про Zed. Оформил подписку, чтобы разные AI агенты через него использовать. Он там в биллинге показывает, сколько каких токенов потрачено, и порой довольно неожиданные цифры получаются. Например, вот был у меня с GPT-5.2 один диалог, где он работал с одним единственным исходным файлом парсера на 25KB (~3600 "слов" согласно wc), он там не с первого раза нужный результат получил, итерации три ушло, в сумме несколько строк поменялись. При этом контекст был заполнен на 100к токенов, а в биллинге возникли 250к Input Tokens и аж 1.3 миллиона Input Cache Read Tokens. Откуда? Такое ощущение, что он там еще по интернету ходит читает всякую документацию и код, пока над задачей думает. Или это что-то другое, кто знает что за кэш там?


А еще там однажды Gemini ***нулся на отличненько, впав в бесконечный цикл. Весело.

z

Dec. 13th, 2025 01:40 pm
thedeemon: (Default)
Из относительно недавних находок и новых привычек, заметно улучшивших ежедневный опыт использования шелла. Программка zoxide добавляет в шелл однобуквенную команду z, заменяющую cd, она запоминает посещаемые папки, и потом в них можно перемещаться, указав только название самой папки, а не выписывать полный абсолютный или относительный путь. Когда есть несколько проектов или мест, где что-то делаешь, потом пишешь просто "z foo" или "z bar" где бы ты ни был, и тебя понимают с полуслова, целиком путь к ним помнить не нужно. А с учетом автодополнения в zsh чаще получается просто "z f<RIGHT ARROW><ENTER>" или "z b<RIGHT ARROW><ENTER>", даже и имя проекта целиком писать не надо. Супер удобно. И да, "z -" возвращает в предыдущую локацию, а "z" - домой.

А, и в рифму, чтоб два раза не вставать. Оказывается, в редактор Zed завезли Helix mode, и в последней версии им уже можно пользоваться. Я раньше для разных проектов использовал то vscode, то Helix. Один хорош для навигации и поиска по большому проекту, второй хорош для непосредственно работы с исходным текстом. Когда-то давно смотрел на Zed, и тогда он был еще молод и проигрывал по обоим применениям. А сейчас развился, оброс темами и расширениями, vim mode и helix mode, и стал объединять в себе хорошие стороны и vscode и Helix. Пусть не идеально, но уже кажется юзабельно. Плюс там есть поддержка ИИ помощников от разных поставщиков - claude, grok, chatgpt, gemini... Я раньше их почти не использовал, в том числе потому что в Helix'e их не было и не ожидается. А тут есть все и сразу. В общем, пробую теперь Zed в качестве основного редактора, посмотрю что получится из этого.
thedeemon: (Default)
Заметил, что уже два года использую компьютер не так, как делал это предыдущие лет 30. А именно, стал использовать auto tiling, когда окна на экране не заслоняют друг друга, а автоматически делят меж собой все пространство экрана. Несколько (переменное количество) виртуальных экранов, меж которыми легко переключаться с клавиатуры. На каждом экране если одно окно - оно занимает его целиком. Если два - делят пополам. Три - 0.5/0.25/0.25, Четыре - опять поровну, и так далее, хотя на практике никакого далее не случается, больше 3-4 окон на одном экране не держу. Ближе к углу экрана, в системной шапке, показана карта рабочих столов и окон на них, например, такая:


Когда к такому режиму привыкаешь (а это довольно быстро происходит), то потом самое интересное случается, когда вдруг оказываешься на системе с традиционными окошками произвольных размеров. Обнаруживаешь, как много ментальных усилий / времени / энергии уходит там на то, чтобы окошки ресайзить, двигать, переключаться. Раньше этого не замечал, а теперь замечаешь. И понимаешь, насколько жизнь проще, когда этого самому делать больше не надо.

Среди нердов-линуксоидов популярны tiling window managers, коих сейчас целая куча (i3, bspwm, sway, awesomewm, xmonad, hyprland, mangowc и пр.), но они обычно выглядят страшно и требуют массу времени на настройку и освоение. У меня же прижился вариант попроще - обычный GNOME (который мне нравится как выглядит) с расширением Forge, которое и делает автотайлинг. Как обычно в tiling WMs, активное окно выделяется цветной рамкой, перемещать фокус между окнами на экране, менять их местами и пр. можно с клавиатуры простыми сочетаниями клавиш, а можно мышкой. В какой-то момент поставил себе его в качестве эксперимента, да вот уже два года так и живу, и на что-то другое менять пока не собираюсь.
thedeemon: (Default)
Про Gullstrand–Painlevé coordinates - систему координат с интересными свойствами для описания решения Шварцшильда для простой статичной черной дыры - я слышал давно. Но только на днях узнал, что Painlevé ее открыл, будучи в промежутке между двумя своими сроками на посту премьер-министра Франции. "Эх, мы о таких премьерах можем только мечтать!" - говорят английские профессора Brian Cox и Jeff Forshaw в своей книжке Black Holes.
thedeemon: (Default)
Интересный момент в корейском языке: там есть чудесный глагол, означающий "дела обстоят таким образом", в инфинитиве это 그렇다 (кырота) - "to be so", "to be that way", где первый слог 그 (кы) значит "вот то", "that".

Много союзных наречий построены на базе этого глагола. Союзы в корейском не стоят отдельными словами, а прикрепляются в конец глаголов, становясь союзными окончаниями. Если союз соединяет два предложения со своими глаголами в одно сложносочиненное, он прикрепляется в конец глагола первого предложения. Но в разговорной речи часто предложения короче, и нужно начать новое предложение с союза, ссылающегося на вышесказанное. Тогда соответствующее окончание прикрепляют к этому глаголу "такие дела", и получаются

그래서 (кыресо) - “So / therefore” - "поэтому / следовательно"
그러니까 (кыроника) - “So / that’s why / I mean” - "из-за этого"
그러면 (кыромён) - “Then / in that case” - "если так"
그리고 (кыриго) - “And / and then” - "и / и потом / а также"
그러나 (кырона), 그렇지만 (кырочиман) - “However / but / still” - "однако / тем не менее"
그런데 (кырондэ) “But / by the way” - "но / однако"
и просто фразы
그래 (кырэ) или 그래요 (кырэё) - "ок, да, это так". Дословно "дела так обстоят".

(и да, в японском есть прямой аналог: それ "сорэ", где そ "со" тоже значит "that", и там получаются слова それで, それなら, それに, それでも, それだから и др.)

В фильмах и сериалах эти все слова очень часто звучат.
Недавно я досмотрел сериал, который на нетфликсе называется Crash Landing on You (в оригинале 사랑의 불시착 - Love's forced landing). Там первая половина происходит в Северной Корее, а во второй половине несколько северных корейцев оказываются в Южной. И я заметил, что северные корейцы там говорят не так, как южные, даже когда слова все те же самые используют. Первое, что замечаешь, это что во всех этих словах вместо "кырэ" у них звучит "кирэ", и в других местах часто "ы" заменяется на "и". Получается, северные корейцы и́кают. Во всяком случае, в этом сериале.

Сериал довольно забавный, особого реализма там ждать не стоит, это скорее такая умилительная сказка с массой позитивных эмоций. Оказывается, в Южной Корее с 1948 года есть закон, запрещающий публичное восхваление Северной Кореи, и создатели сериала очень старались его не нарушить, даже значки на одежде северных корейцев сделали размером поменьше, чем реальные. Однако даже при всех их стараниях все равно Северная Корея там выглядит на удивление опрятно и приятно. Пусть бедно и просто, но все равно какой-то лоск заметен. То ли она правда такая опрятная, то ли южнокорейские киношники просто не способны нужную разруху представить и воспроизвести. А некоторые культурные и визуальные моменты смотрятся очень знакомо для советского человека. Например, когда герой берет у отца-генерала машину со специальными номерами, по которым все местные гаишники понимают, что ее не стоит останавливать, и регулировщики (которые там до сих пор активно работают вместо светофоров) ее везде пропускают.
thedeemon: (Default)
Я очень редко играю в игры, но в этом месяце неожиданно увлекся одной, да так сильно, что потратил там часов 60 пока не дошел до финальных титров. Это Watch Dogs Legion, игра вышла лет 5 назад, и как будто никто о ней ничего хорошего не слышал, вы будете первые. Я помню, несколько лет назал когда услышал какие-то анонсы про нее, подумал "о, это как GTA только в Лондоне, интересно". Потом года 3 назад подписался на сервис игр в облаках GeForce Now, поставил ее там, часик покатался по городу, да забросил. В тот момент как-то не до нее было, и лень было вникать. По сюжету там действие происходит в недалеком будущем в антиутопическом Лондоне, где после серии терактов частная военная компания взялась за обеспечение безопасности, но разумеется переусердствовала, поэтому город заполнен ее солдатами, которые всех обижают, повсюду ее логотипы, дроны, тотальная слежка и т.п. В реальности мы до такого пока не дожили, но если полистать твиттер, то может сложиться ощущение, что уже к тому близко. :) В общем, спустя годы я вдруг решил еще раз попробовать в нее поиграть, и в этот раз сильно протащился.


В первую очередь конечно тем, как здорово там воспроизвели центральную часть Лондона, насколько он узнаваем (ниже скриншотов добавил). Я за годы с начала ковидных времен исходил пешком этот город вдоль и поперек, по крайней мере западную его половину и центр, и радость узнавания реальных улиц и зданий меня в игре ждала на каждом углу практически. Разумеется, почти все самые знаменитые места тут стали вместилищами для миссий, поэтому по мере прохождения побываешь внутри и замка Tower, и моста Tower Bridge, небоскребов The Shard и walkie talkie, наведешь шухер в зданиях MI6 и New Scotland Yard, на территории Buckingham Palace и под ней, внутри телевышки BT tower, внутри и под Battersea power station (из которой сейчас торговый центр сделан кстати, в реальности и в игре), внутри башни с Big Ben и т.д. Пара миссий проходят буквально через дорогу от моего офиса. :) Они не стали копировать все улицы один в один, а сжали все, убрав неважные улочки и оставив важные, но в целом география вполне узнаваемая, поэтому ориентироваться довольно легко.

( Read more... )
thedeemon: (Default)
Сыну на лето в школе дали список книг почитать, среди них Six Easy Pieces Фейнмана, где он рассказывает про двухщелевой эксперимент с электронами, дескать если их запускать через забор с двумя дырками и ловить на экране дальше, то каждый конкретный электрон попадет в какую-то случайную точку, а распределение этих точек будет выглядеть как результат интерференции волн. Он много говорит "в эксперименте видим то", "в эксперименте видим сё", но перед этим предупреждает, что вообще-то именно в таком виде эксперимент не делали, и описываемый эксперимент только мысленный. Впрочем, говорит, было много других экспериментов, где подобное квантовое поведение наблюдали.

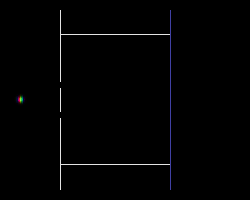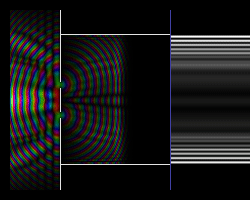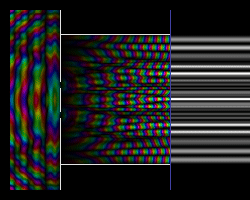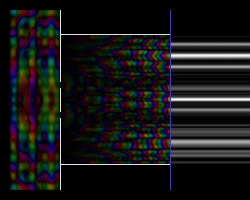
А недавно я услышал в одном подкасте с Jacob Barandes один интересный момент: он говорит, что если мы захотим посчитать, какое именно должно получиться распределение попадания частиц на экране, казалось бы тривиальнейшая задачка в КМ, то мы до сих пор не знаем как это правильно сделать. Казалось бы, вот начальное значение волновой функции, вот мы ее по уравнению Шредингера эволюционируем во времени, и вот она приходит на экран, и мы там можем взять квадрат модуля ВФ и из него получить распределение вероятностей попадания в разные места. Но! Мы же это делаем, взяв значение ВФ в какой-то момент. А в какой? Когда именно электрон прилетит на экран? Этого мы не знаем. В каждый момент времени он потенциально может быть найден где угодно, ВФ нам говорит вероятности его нахождения в разных местах. Если мы зафиксируем момент и произведем "измерение" координаты, получим какую-то точку. А в какой момент это делать? В каждый конкретный момент частица скорее будет где-то еще, а не на экране. Вот простой пример:


Тут яркость обозначает амплитуду волновой функции, а цвет - комплексную фазу. Исходно частица локализована в небольшое круглое облачко (гауссиан) и в комплексной плоскости ее ВФ закручена так, чтобы иметь испульс для движения вправо. По мере эволюции облачко расплывается в пространстве и сначала в целом движется вправо, встречает представленную потенциальным барьером стенку с двумя щелями, частично проходит через них (а большей частью отражается от стенки), там дальше корридор (я добавил сверху и снизу стенки, чтобы отражения интереснее давали картинку) и в конце стоит голубой экран, на котором мы как бы частицу ловим. Справа от экрана я показываю яркостью квадрат модуля ВФ на самом экране в каждый момент, отнормированный. Видно, что в разные моменты там несколько разные картинки. Можем ли мы какую-то одну из них считать предсказанием? Вряд ли. Можем ли как-то суммировать и усреднять? Тоже непонятно, мы не знаем с какими весами суммировать, каково распределение по времени событий прилета частицы. Оператора времени в КМ нет, время - не observable величина. И если в какой-то момент частица прилетает, то ВФ схлопывается, дальше эволюционировать старую ВФ уже нельзя, поэтому как и что тут суммировать - неочевидно.

Такой вот простой вопрос неожиданно оказался сложным, по крайней мере я не в курсе как его принято решать, а Jacob говорит, что по-хорошему и никто не в курсе.

Исходники симуляции, если что, здесь.
thedeemon: (Default)
Многие читали или слышали про излучение Хокинга, где якобы пары виртуальных частиц разделяются у горизонта, одна из которых улетает и становится тем излучением. Но немногие в курсе, насколько это история обмана, насколько далека эта сказка от того механизма, что Хокинг реально описал в своих работах.

Из старого поста Сабины Хоссенфельдер на эту тему:

One of the particles gets caught behind the horizon and falls in, the other escapes. The result is a steady emission of particles from the black hole horizon. It’s simple, it’s intuitive, and it’s wrong.

Hawking’s is an illustrative picture, but nothing more than that. In reality – you will not be surprised to hear – the situation is more complicated.
...
This simple image that Hawking provided for the non-specialist is not backed up by the mathematics. It contains an element of the truth, but take it too seriously and it becomes highly misleading.


Скопирую сюда, что недавно писал на одном форуме:

В 1974 году Хокинг выпускает сначала короткую заметку на пару страниц, а затем в 1975 более длинную и подробную статью, где описывает рождение частиц в результате образования черной дыры. Реально описанный им механизм звучит примерно так. Берем простейшее скалярное эрмитово поле и сначала смотрим на него в плоском пространстве, где никакой ЧД еще нет. Его можно разложить через Фурье "по частотам", как сумму простых волн, и исходно в разложении там будут положительные и отрицательные частоты во времени. Частота во времени определяет энергию, частиц с отрицательной энергией не бывает, и при переходе к квантовому полю и операторам, положительным и отрицательным модам соответствуют операторы уничтожения и создания частиц положительной энергии.
Вакуумное состояние по определению не содержит реальных частиц, и значит для каждой моды воздействие оператора уничтожения частицы на него дает ноль.

Дальше у нас образуется черная дыра, пространство искривляется, появляется горизонт событий, и в этой новой геометрии базис, по которому мы раскладываем поля, изменяется, это больше не старые простые волны в плоском пространстве, а новый набор базовых решений, с учетом наличия горизонта событий. Преобразование Боголюбова позволяет перейти от старого базиса к новому, выразить новые базисные моды через линейную комбинацию старых и наоборот. И тут можно заметить, что квантовое состояние, которое было вакуумом в старом базисе, в новом базисе уже вакуумом не является: для каждой моды можно посчитать матожидание количества таких частиц в этом состоянии, и оно выражается через коэффициенты пребразования между старым и новым базисом, и оказывается ненулевым. Т.е. если изначально в плоском пространстве у нас был вакуум, то это самое состояние в новом базисе новой геометрии уже содержит реальные частицы, это больше не вакуум. Эти реальные частицы и есть излучение Хокинга. Ни слова о виртуальных частицах.

Дальше идет зубодробительная математика, показывающая нелокализуемый поток негативной энергии через горизонт, от которого ЧД должна худеть.

Тут Хокинг понимает, что это все слишком абстрактно и неинтуитивно, и хорошо бы придумать какую-то операционную картину, что-то более понятное и ощутимое, и выдает в порядке бреда что-то про виртуальные частицы отрицательной энергии, которых вообще вроде как не бывает, но они могут туннелировать через горизонт внутрь ЧД, где время в метрике имеет другой знак, а потому снаружи кажется, что там у них положительная частота и энергия, так эти небывалые частицы своим туннелированием несут снаружи поток негативной энергии. Но добавляет "It should be emphasized that these pictures of the mechanism responsible for the thermal emission and area decrease are heuristic only and should not be taken too literally."

В конце 80-х он выпускает книжку для широкой публики, которую нельзя пугать сложными словами про базисы операторов квантовых полей, и там он выдает еще более примитивную картинку про пары вирт. частиц, еще более далекую от реального механизма из своих работ. Именно эту сказку все запоминают и с тех пор считают описанием излучения Хокинга, хотя и каждый раз удивляются массе несуразностей в ней (что за негативные частицы там и почему именно они падают в ЧД, а не другие).
thedeemon: (Default)
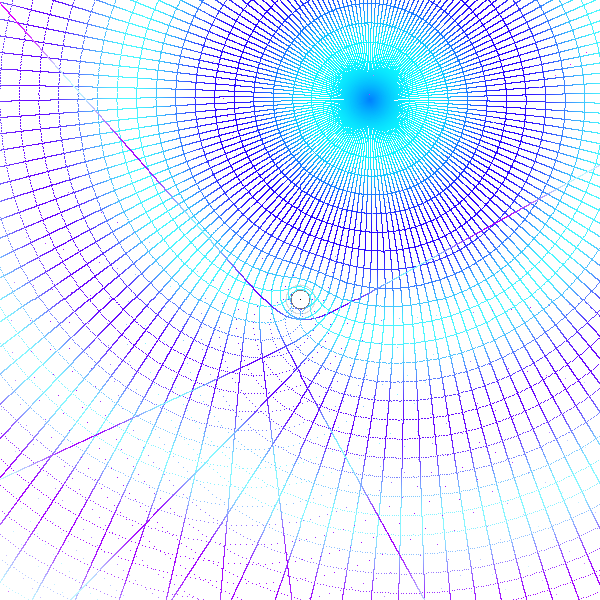
Вдохновившись одной недавней беседой, сделал вчера симуляцию, как свет от одного события (вроде вспышки сверхновой) идет мимо черной дыры и приходит в некоторые места 2-3 раза - разными путями и в разное время. 2Д пространство + время, метрика Шварцшильда. Получились довольно забавные мультики. Видно, как при приближении к массивному телу свет "притормаживает" с т.з. далекого наблюдателя. Shapiro delay вроде как и у Солнца наблюдали - мимо него радиосигналы от космических аппаратов дольше шли.


То же, но в одной картинке. Одинаковый цвет = одинаковое время (coordinate time):


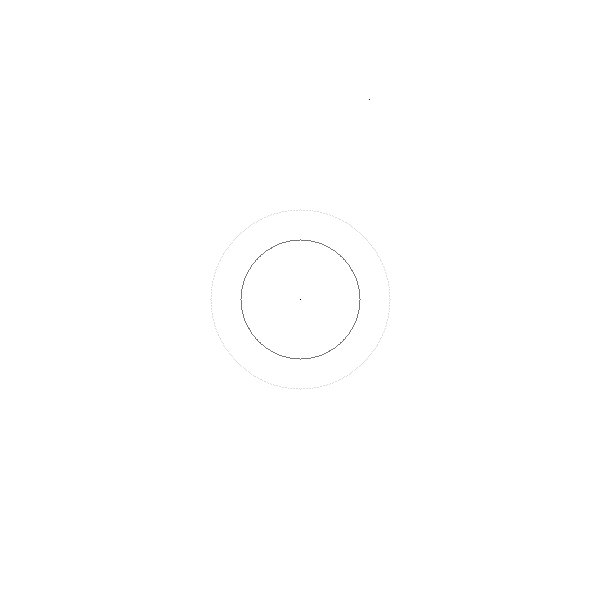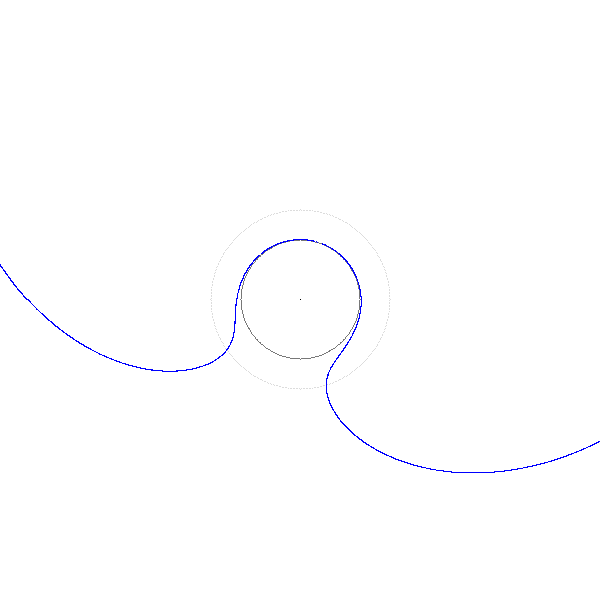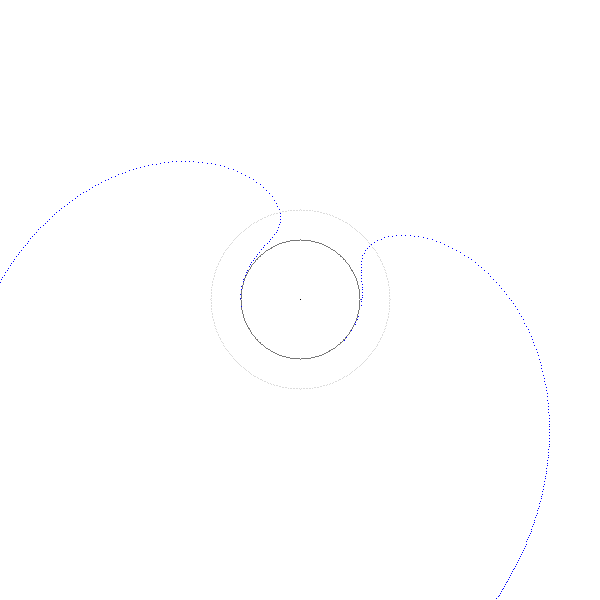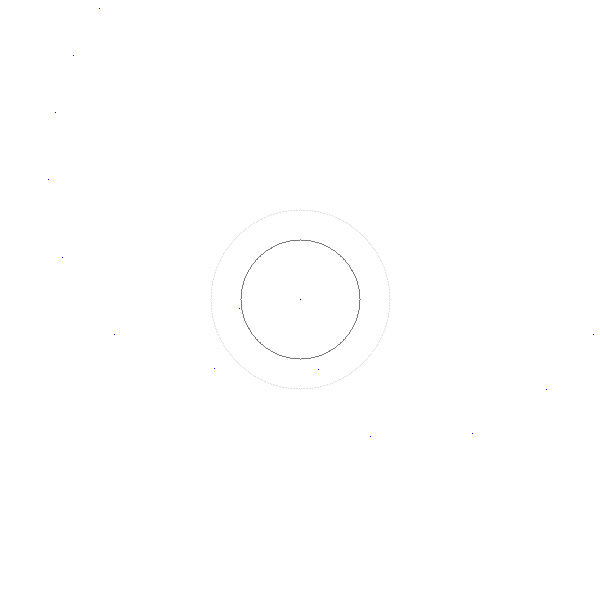
А вот ЧД побольше. Помимо горизонта событий я рисую еще фотонную сферу - по которой теоретически свет может вечно круги наматывать. Если он извне ее пересечет, то непременно упадет на горизонт. А если мимо пролетит, то завернет и даже покружиться вокруг может, но потом все же улетит прочь. Тут это видно как раз:


Исходники: https://gist.github.com/thedeemon/76050df87070fbb51a2ea8ea52fce4c7

1880

Apr. 5th, 2025 03:25 pm
thedeemon: (Default)
Я в детстве классики мало читал, а что читал, то забыл, сейчас частично компенсирую. Недавно добрался до "Братьев Карамазовых" Достоевского. Два неожиданных момента: книга писалась в 1878—1880 годах, когда Эйнштейн только рождался, но уже тогда рядовые люди знали, что свет от Солнца 8 с лишним минут к нам идет, и про неевклидову геометрию Федор Михалыч уже в курсе был. Один из героев говорит:

"Между тем находились и находятся даже и теперь геометры и философы, и даже из замечательнейших, которые сомневаются в том, чтобы вся вселенная или, еще обширнее – все бытие было создано лишь по эвклидовой геометрии, осмеливаются даже мечтать, что две параллельные линии, которые, по Эвклиду, ни за что не могут сойтись на земле, может быть, и сошлись бы где-нибудь в бесконечности. Я, голубчик, решил так, что если я даже этого не могу понять, то где ж мне про Бога понять."

Примечательно, что молодому герою романа хватило мудрости принять и смириться со своим непониманием, а сейчас иные условные retired engineers, не знакомые даже с базовыми идеями и понятиями, продолжают приходить в комментарии и бороться с "неправильной математикой".

Profile

thedeemon: (Default)
Dmitry Popov

November 2026

S M T W T F S
1234567
891011121314
15161718192021
22232425262728
2930     

Syndicate

RSS Atom

Most Popular Tags

Style Credit

Expand Cut Tags

No cut tags
Page generated Nov. 19th, 2026 09:14 am
Powered by Dreamwidth Studios